Orux AI / 模型观察
Kling v3 API 视频帧检查:放进 24 fps 时间线之前
用已有 Kling v3 微距案例,检查121个解码帧与120帧剪辑位置的差异。运行 Python 输出逐帧时间表与拟定剪辑方案,分开判断动作、时长和费用。
文章目录
锁定五秒剪辑位置前,先检查实际解码帧
仅凭“五秒”这个请求参数,还不足以把 Kling v3 视频放进精确的 120 帧、24 fps 时间线位置。 应检查交付文件。本文分析的 Orux 已有口琴簧片案例,请求时长为五秒,但保存的 MP4 实际包含 121 个解码视频帧,帧率为 24 fps,文件报告时长为 5.041667 秒。这是需要处理的剪辑边界,本身不能证明生成失败或账单有误。
对于正在拼接机械细节插入镜头的剪辑师,真正有用的交付物是一份带帧索引的入库检查报告。下方 Python 示例会输出完整时间戳 CSV 和拟定剪辑方案:五秒位置保留从零开始编号的 0–119 帧,单独检查第 120 帧。程序不会修改或导出视频。下方保留原片,便于同时判断可见动作与时间信息。
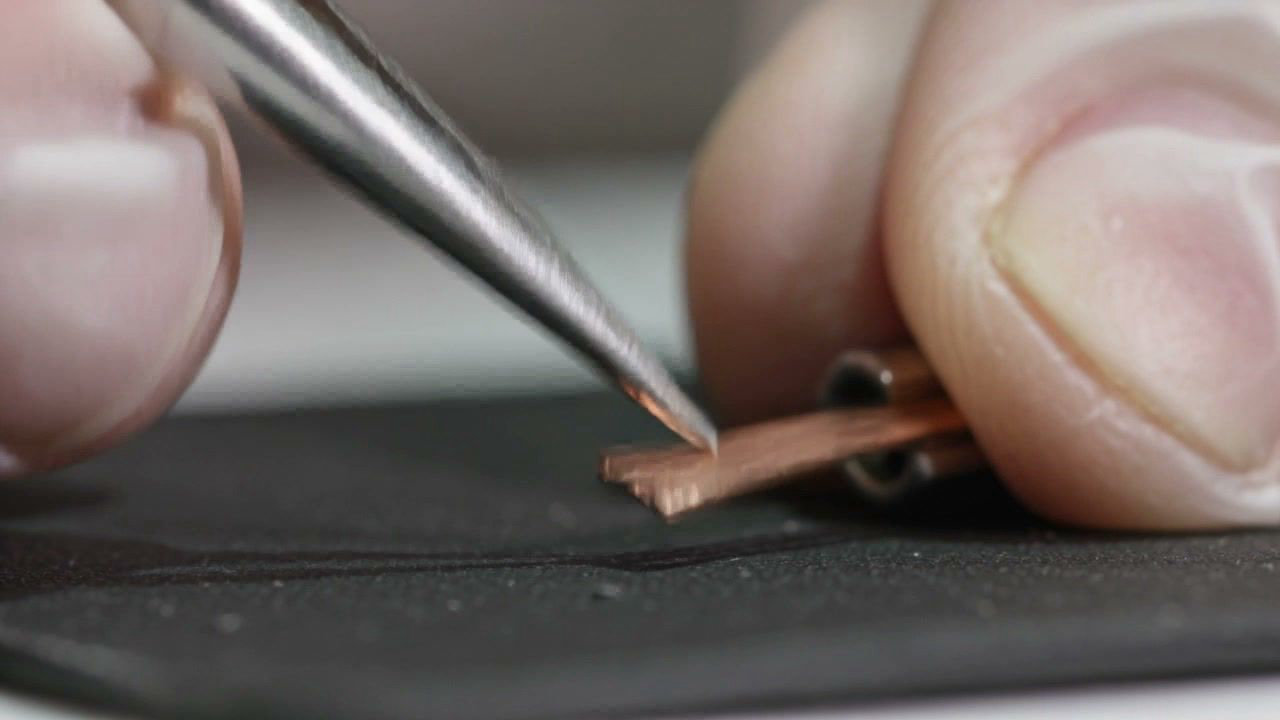
真实源文件第 72 帧,呈现时间为 3.000000 秒。画面提取自已有模型案例,不是新生成的图片。
真实的 Kling v3 案例与保存参数
素材来自 Orux Kling v3 模型页。保存的案例以超近景表现镊子与铜质口琴簧片的接触,原始提示词如下,保持原文:
维修者用细镊子轻拨一片铜簧片,簧片短暂振动后静止,超近距单镜头。
供英文读者理解的译意是:“维修者使用精细镊子轻拨一片铜簧片,簧片短暂振动后静止,以单一超近景呈现。”这份译文只是解释保存的输入,不是另一次生成使用的新提示词。
保存的参数为 duration: 5、aspect_ratio: "16:9"、mode: "std"、sound: "off" 和 kling_v3_type: "t2v"。该案例没有记录参考图片输入,因此不能把它描述成已经证明能保留原图内容的图生视频测试。本文没有发起新的模型请求。
原始保存的 Kling v3 案例,请求参数为五秒、std 模式、关闭声音。本文检查的文件包含 121 帧、24 fps,并非为这篇文章新生成的视频。
2026 年 11 月 3 日核对的当前公开表单,提供 3 至 15 秒时长、16:9/9:16/1:1 比例、std/pro 模式及声音开关。这些选项对应本次核对的 Orux 接入。本文不据此推断额外的原生模型控制项,也不声称切换模式就能修复某种可见动作。
六张抽样帧能说明什么,不能证明什么
源文件为 1,280 × 720;检查到的文件没有音频流,与保存的关闭声音设置一致。在抽样时刻,画面始终是手指、镊子与簧片的近景。接近三秒时,簧片在接触区域的可见形态发生变化;后续抽样画面中,镊子相对这个接触位置已经撤开。
这些观察有助于决定动作应该放在剪辑中的哪个位置,却不能测量真实簧片的振动频率、证明机械运动准确,或保证所有中间帧都没有瑕疵。每秒抽一张静帧,不能确立快速振动周期。在把它用作示意性插入镜头以外的素材之前,应观看原片,并检查相关的中间帧。
| 从零开始的源帧编号 | 呈现时间 | 对该抽样画面的剪辑观察 |
|---|---|---|
| 0 | 0.000000 s | 建立近景,能看到手指及簧片附近的镊子 |
| 24 | 1.000000 s | 镊子仍在簧片附近,操作区域依然可见 |
| 48 | 2.000000 s | 明显形态变化前的另一张接触区域参考帧 |
| 72 | 3.000000 s | 接触区域的簧片看起来更宽,或有抬起的形态 |
| 96 | 4.000000 s | 相对三秒时的接触位置,镊子已经撤开 |
| 120 | 5.000000 s | 最后一张抽样帧从五秒边界开始呈现 |
左右滑动查看完整表格。
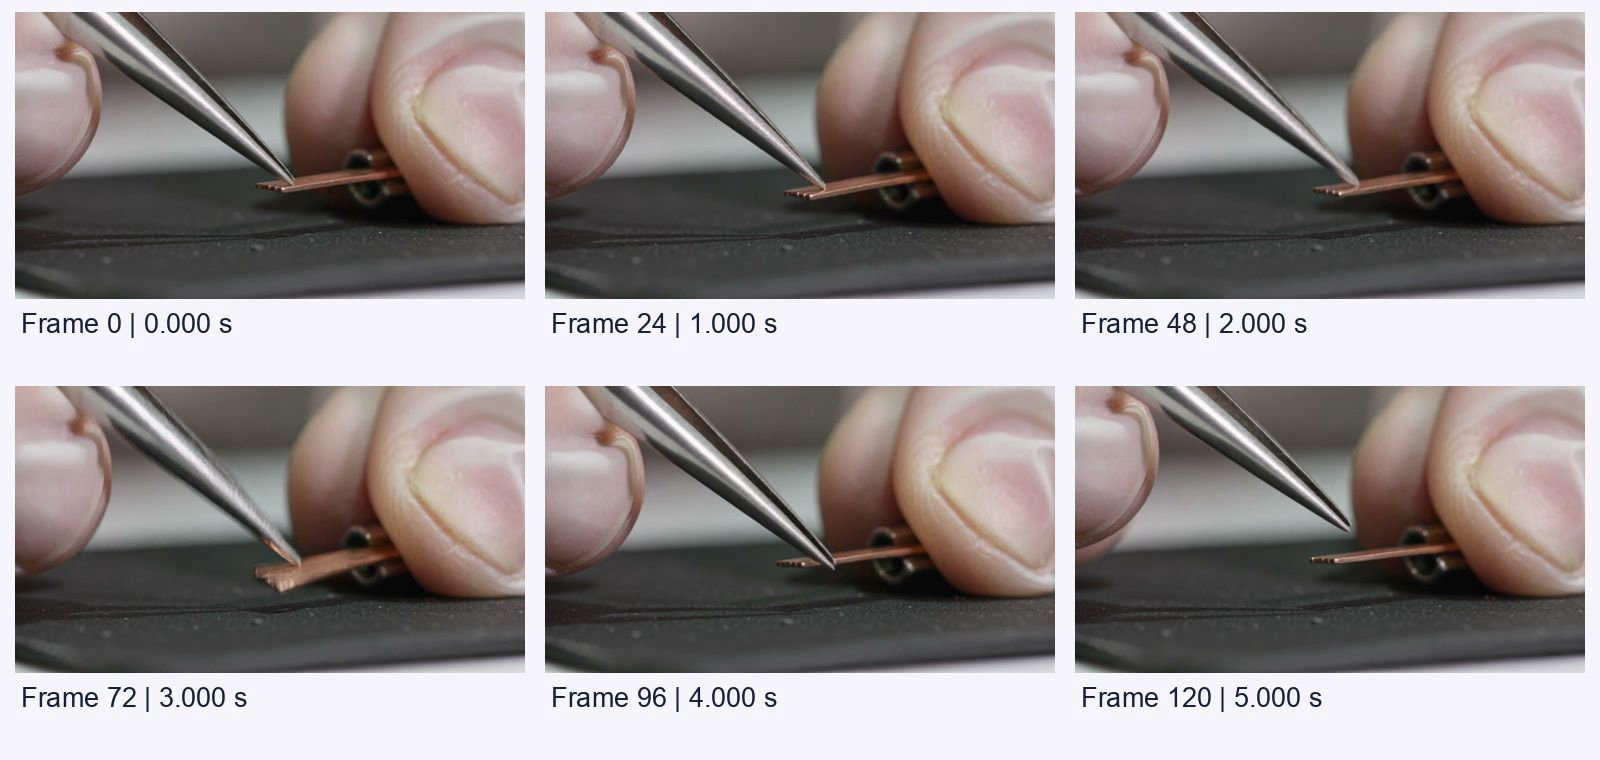
按记录的呈现时间提取的源帧:0、24、48、72、96、120。每帧保留完整构图,标签与帧对照图版式由本地添加。
如果要做另一类视觉选择,Kling 4.0 同提示词镜头比较讨论了如何在已有候选镜头之间取舍。本篇只有一条保存的镜头,问题是它的实际帧时间怎样适配剪辑。两篇文章都没有把少数观察扩展成整个模型的可靠性分数。
最后一帧的时间戳,不等于视频结束时间
在精确 24 fps 下,一个帧间隔为 1/24 秒,约 0.041667 秒。五秒位置包含 120 个帧间隔。采用从零开始编号、且源文件从零时刻开始的前提,帧起始时间依次为 0、1/24、2/24,直到 119/24,即 4.958333 秒。
下一帧,也就是第 120 帧,从 5.000000 秒开始。如果把这一帧再保留一个帧间隔,总时长就是 121/24,约 5.041667 秒。因此,最后一帧的呈现时间戳与文件报告时长可以不同,两者并不矛盾。通常用半开区间 [0, 5) 表达的时间线位置,不包括恰好从五秒开始的帧。
检查程序读取实际呈现时间戳,而不是把平均帧率标签乘一下就相信结果。它核对每一个解码时间戳是否落在假定的 24 fps 网格上,误差不超过两微秒,以容纳本次返回的六位小数时间戳表示。这个容差是针对本样本的解析检查,不是人眼画质阈值。
对于可变帧率文件或 23.976 fps 工程,不能直接照搬同样的算式,它们需要不同的时间处理策略。代码会明确拒绝其他平均帧率,以及不符合恒定帧率假设的时间戳序列。它输出的是边界明确的入库检查方案,不是自动帧率转换工具。
请求参数的费用预算,与文件检查分开计算
以下 Orux 当前售价核对日期为 2026 年 11 月 3 日。配置换算为 1 Credit = USD 0.005。单价的单位为对应模式与声音设置下的每生成秒。五秒一栏,是对新请求的算术规划,不是这条已有案例的历史收费。
| Kling v3 设置 | 当前 Orux 每秒售价 | 计划中的五秒请求 |
|---|---|---|
std、关闭声音——本案例保存设置 | 16.00008 Credits(USD 0.0800004) | 80.0004 Credits(USD 0.400002) |
pro、关闭声音 | 21.33336 Credits(USD 0.1066668) | 106.6668 Credits(USD 0.533334) |
std、开启声音 | 24.00024 Credits(USD 0.1200012) | 120.0012 Credits(USD 0.600006) |
pro、开启声音 | 32.00016 Credits(USD 0.1600008) | 160.0008 Credits(USD 0.800004) |
左右滑动查看完整表格。
本文没有产生新的生成费用。检查已有本地文件、输出 CSV、决定保留哪些帧,都不需要再调用一次模型。剪掉一帧也不能据此要求退款或改变历史生成费用。本文没有使用原始案例的账单回执,因此不能把文件的 5.041667 秒元数据当作实际按多少秒计费的证据。
如果确实需要新的创作方向,申请另一条镜头前,应核对当前设置与账户报价。如果唯一的问题是把一条原本可用的视频放进精确位置,则应先解决时间线决策。接入细节请查阅 Orux API 文档;本流程针对交付文件,不讨论 API 轮询或重试机制。
运行帧检查,并保留源文件
安装 FFmpeg,确保命令行可以运行 ffprobe,并使用 Python 3.9 或更高版本。ffprobe 官方文档介绍了流信息检查、解码帧计数与逐帧信息。除本地 ffprobe 可执行程序外,下方代码只使用 Python 标准库。
从嵌入播放器或模型页保存已有视频,命名为 source.mp4,再把下方内容保存为 audit_clip.py。在可写目录中运行 python3 audit_clip.py source.mp4。应使用网站正常的视频访问流程;不带站点预期请求上下文的原始下载器,可能被 CDN 拒绝。程序本身不会下载素材,不访问模型端点,也不使用 API Key。
import csv
import hashlib
import json
import subprocess
import sys
from decimal import Decimal
from fractions import Fraction
from pathlib import Path

EXPECTED_SHA = '5c948c89baf54c46c85afe65c33636bebb8a6a79acc22eebcce2412aef3e5515'
SOURCE = Path(sys.argv[1] if len(sys.argv) > 1 else 'source.mp4')
TARGET_RATE = Fraction(24, 1)
TARGET_SECONDS = 5

def probe(*args):
    command = ['ffprobe', '-v', 'error', *args, '-of', 'json', str(SOURCE)]
    return json.loads(subprocess.run(command, check=True, capture_output=True, text=True).stdout)

def audit_timestamps(times, rate):
    if not times or rate <= 0:
        raise ValueError('missing frames or invalid rate')
    origin = times[0]
    for index, timestamp in enumerate(times):
        expected = origin + Decimal(index * rate.denominator) / rate.numerator
        if abs(timestamp - expected) > Decimal('0.000002'):
            raise ValueError('timestamps do not match the assumed constant rate')

def main():
    if hashlib.sha256(SOURCE.read_bytes()).hexdigest() != EXPECTED_SHA:
        raise ValueError('sample changed; inspect the new file before auditing')
    info = probe('-count_frames', '-show_entries',
                 'stream=index,codec_type,width,height,avg_frame_rate,nb_read_frames:format=duration')
    video = next(s for s in info['streams'] if s['codec_type'] == 'video')
    rate = Fraction(video['avg_frame_rate'])
    if rate != TARGET_RATE:
        raise ValueError('this example expects an exact 24 fps source')
    raw = probe('-select_streams', 'v:0', '-show_frames', '-show_entries',
                'frame=best_effort_timestamp_time')['frames']
    times = [Decimal(row['best_effort_timestamp_time']) for row in raw]
    audit_timestamps(times, rate)
    if int(video['nb_read_frames']) != len(times):
        raise ValueError('decoded frame counts disagree')
    target_count = TARGET_SECONDS * TARGET_RATE.numerator // TARGET_RATE.denominator
    if len(times) < target_count:
        raise ValueError('source is shorter than the target slot')
    with Path('frame-times.csv').open('w', newline='') as handle:
        writer = csv.writer(handle)
        writer.writerow(['zero_based_frame', 'presentation_seconds'])
        writer.writerows((i, str(t)) for i, t in enumerate(times))
    plan = {
        'width': video['width'], 'height': video['height'],
        'source_rate': str(rate), 'decoded_frames': len(times),
        'container_seconds': info['format']['duration'],
        'last_presentation_seconds': str(times[-1]),
        'audio_streams': sum(s['codec_type'] == 'audio' for s in info['streams']),
        'target_frames': target_count, 'keep_frames_inclusive': [0, target_count - 1],
        'last_kept_presentation_seconds': str(times[target_count - 1]),
        'frames_outside_slot': len(times) - target_count,
        'edit_applied': False,
    }
    Path('edit-plan.json').write_text(json.dumps(plan, indent=2) + '\n')
    print(json.dumps(plan, indent=2))

if __name__ == '__main__':
    main()
实际执行结果包含 decoded_frames: 121、target_frames: 120、keep_frames_inclusive: [0, 119]、frames_outside_slot: 1、last_kept_presentation_seconds: "4.958333" 和 edit_applied: false。生成的 CSV 除表头外共有 121 行数据;报告还记录了 1,280 × 720 尺寸与零音频流。
原始 MP4、文件哈希、时间戳 CSV 与剪辑方案应一起留存。固定哈希有意将本复现示例限定在已检查文件上。若换成另一份获准使用的素材,应先检查它,再明确调整预期哈希和时间假设,不要只为得到通过结果而删除检查。代码会把逐帧元数据载入内存,适合短视频,不是面向长片素材库的工具。
明确记录剪辑决策
对这个样本,有两种合理选择:周边序列允许时,保留完整 121 帧、约 5.041667 秒的源视频;或者为精确 120 帧的位置,提出保留 0–119 帧的方案。代码生成的是后者。本文没有提供或声称已完成裁剪导出。
在剪辑软件中应用方案前,应检查源帧 119 与 120,以及它们附近的完整动作。确认所选出点不会删掉重要的最后姿态、造成意外跳变,或与相邻镜头冲突。如果工程需要更长的动作落稳停留,现有五秒位置可能本来就是不合适的创作限制。帧数检查不能代替这个艺术判断。
在自己的流程中应用剪辑或完成导出后,应再次检查新文件。源文件报告不能为后续导出的时间、声音或画质作保证。本篇交付的是可核对的素材交接依据:已知来源、实测时间戳、明确的拟保留帧范围,并将创作审片、时间线时长与生成费用清楚分开。
常见问题
五秒请求都会返回 121 帧吗?
本文没有确立这样的通用规律。这一条保存的 Kling v3 文件,在 24 fps 下包含 121 个解码帧。应逐一检查交付文件,不能把本样本的边界表现当作整个模型的保证。
本例中,精确五秒位置应该放哪些帧?
第 0 至 119 帧适合本文设定的 120 帧、24 fps 位置。第 119 帧从 4.958333 秒开始,第 120 帧从 5.000000 秒开始,落在 [0, 5) 之外。代码只提出这个范围,没有实际剪辑。
多出一帧能证明我被多收了费用吗?
不能。仅凭文件时长,不能确定计费依据或历史费用。价格表是对请求设置的注明日期的规划计算,本文没有检查保存案例的账单回执。
帧对照图能证明簧片振动准确吗?
不能。它展示的是选定姿态与镊子位置,不是对物理振动的测量。应观看原始动作判断剪辑适用性,不能用生成视频证明机械运动准确。
检查程序生成或修改视频了吗?
没有。它只检查已有 MP4,并输出时间戳 CSV 与拟定剪辑方案 JSON。没有付费模型调用,也没有提供裁剪成片、帧率转换或新配音。
用一个 API 调用这些模型
一个 OpenAI 兼容 API,覆盖对话、图像、视频与音频模型,按积分计费。
相关文章
浏览全部文章 →
低价视频 API 怎么选:Vidu、Wan、Kling 与 Seedance
按2026年10月29日候选快照比较 Vidu、Wan、Kling 和 Seedance 的每秒、整段费用及输入限制,区分图生与文生、音频和画质条件。附完整批量Python代码与真实案例,诚实列出 Orux 较贵之处,复核 fal 和官方价,并说明价格舍入、任务恢复与临时链接边界。

Kling 4.0 API 价格:参数、恢复脚本与真实视频
核对 Kling 4.0 在 Orux 的720p与1080p秒价、整段预算及 fal 当前价格,明确36%差价的比较方向。提供完整参数表、可保存任务ID的Python脚本和两段同提示词真实案例,说明首尾帧、参考图片、主体、音色与时长限制,以及脚本恢复和成功重试的计费边界。并保留查价日期。

Embedding API 迁移:重建向量索引与可回退切换
从 text-embedding-3-small 迁移到 large,不能只补齐向量维度。用离线 Python 验证六类错误,核对重建费用、存储占用与编码器和索引成对切换方案。