Orux AI / 模型观察
每张被接受图片的成本:把重试算进图像 API 预算
按每张被接受图片的成本而不是标价来做图像生成预算。包含六个模型 2026 年 11 月的当前 Credits 价格、重试实算示例,以及一个可切换模型的异步 Python 客户端。

文章目录
模型页上的数字,是一次尝试的价格。你的应用真正买单的,是一张被接受的图片。如果便宜的模型要试两次才出一张可用图,而贵一点的模型一次就对,那标价几乎说明不了什么。本文介绍如何按每张被接受图片的成本(cost per accepted image)来做图像生成预算,使用 Orux AI 六个模型的当前标价,并说明如何把这些模型放在同一个小型异步客户端后面,切换流量时无需重写应用。
下文所有价格均于 2026-11-04 从 Orux AI 模型页读取。其中多个模型的价格低于我们 10 月定价文章中的数字,请以本表为准,不要沿用旧表。1 Credit = $0.005。
为什么标价是错误的计量单位
Orux AI 的图像请求按成功生成的图片计费。以 FAILED 或 EXPIRED 结束的任务不收费。听起来像是只为有效结果付费,但"成功"指的是模型返回了一张图,而不是这张图适合你的产品。产品颜色不对、文字断裂或构图别扭的图片,依然算成功,依然扣 Credits。
所以真实的预算公式有两部分:
- 每次尝试的标价,可以直接在模型页读到。
- 每张被接受图片所需的尝试次数,取决于你的提示词、审核标准和模型,只能自己测量。
每张被接受图片的成本 = 标价 × 每张被接受图片的尝试次数。
如果生成 100 张、接受 77 张,那么每张被接受图片的尝试次数就是 100 ÷ 77 ≈ 1.3。这个比值是图像预算里最重要的数字,却几乎没人记录。
当前标价(2026-11-04 核对)
| 模型 | 分辨率 | 每张标价 | 美元等值 | 参考图 | 备注 |
|---|---|---|---|---|---|
| Nano Banana 2.1 | 1K / 2K / 4K | 2.281 Cr(1K);2.667 Cr(2K、4K) | $0.0114;$0.0133 | 最多 10 张 | 宽高比选项最多,含 1:8 和 8:1 |
| flux-2-pro | 仅 1K | 2.67 Cr | $0.0134 | 不支持(仅文本) | 仅 1:1 |
| GPT Image 2.5 Sunburst | 1K / 2K / 4K | 2.667 Cr(所有尺寸) | $0.0133 | 最多 16 张 | 4K 与 1K 同价 |
| Wan2.7 Image | 1K / 2K | 4.333 Cr(0–9 张参考图) | $0.0217 | 最多 9 张,不加价 | 5 种宽高比 |
| Qwen Image 3.0 Pro | 1K / 2K | 6.667 Cr(1K);13.33 Cr(2K),无参考图 | $0.0333;$0.0667 | 最多 3 张,每张加价 | 文字排版与海报 |
| Seedream 5.0 Pro | 1K / 2K | 7.5 Cr(1K);15 Cr(2K),无参考图 | $0.0375;$0.075 | 最多 10 张,每张加价 | 产品图、人像 |
左右滑动查看完整表格。
怎么看这张表:
- 有三个模型在每张 2.3–2.7 Credits 左右:Nano Banana 2.1、flux-2-pro 和 GPT Image 2.5 Sunburst。Wan2.7 Image 居中。Qwen Image 3.0 Pro 和 Seedream 5.0 Pro 在 1K 时约贵 2.5 到 3.3 倍,2K 时再翻一倍。
- 在 Nano Banana 2.1、GPT Image 2.5 Sunburst 和 Wan2.7 Image 上,参考图不额外收费。Qwen Image 3.0 Pro 带 3 张参考图的 1K 图片为 8.267 Cr($0.0413);Seedream 5.0 Pro 带 10 张参考图的 1K 图片为 12.5 Cr($0.0625)。如果你的流程以编辑为主,请按这些档位计算,而不是无参考图价格。
- flux-2-pro 便宜但有限制:在 Orux AI 上目前只支持 1K 和 1:1,不支持参考图。如果你需要 16:9 横幅或编辑功能,它再便宜也用不上。
实算示例:每张被接受图片的成本
下面的尝试次数是用于说明的假设,不是实测数据。试点运行之后,请换成你自己的数字。
| 模型(1K,无参考图) | 标价 | 1.0 次尝试 | 1.3 次尝试 | 2.0 次尝试 | 对比 Seedream 5.0 Pro(1.0 次)的盈亏平衡点 |
|---|---|---|---|---|---|
| Nano Banana 2.1 | 2.281 Cr | 2.281 Cr($0.0114) | 2.965 Cr($0.0148) | 4.562 Cr($0.0228) | 3.29 次 |
| flux-2-pro | 2.67 Cr | 2.67 Cr($0.0134) | 3.471 Cr($0.0174) | 5.34 Cr($0.0267) | 2.81 次 |
| GPT Image 2.5 Sunburst | 2.667 Cr | 2.667 Cr($0.0133) | 3.467 Cr($0.0173) | 5.334 Cr($0.0267) | 2.81 次 |
| Wan2.7 Image | 4.333 Cr | 4.333 Cr($0.0217) | 5.633 Cr($0.0282) | 8.666 Cr($0.0433) | 1.73 次 |
| Qwen Image 3.0 Pro | 6.667 Cr | 6.667 Cr($0.0333) | 8.667 Cr($0.0433) | 13.334 Cr($0.0667) | 1.12 次 |
| Seedream 5.0 Pro | 7.5 Cr | 7.5 Cr($0.0375) | 9.75 Cr($0.0488) | 15 Cr($0.075) | 1.00 |
左右滑动查看完整表格。
最后一列回答了一个实际问题:便宜的模型最多可以尝试几次,才会在每张被接受图片的成本上追平"每次都一次通过"的 Seedream 5.0 Pro?Nano Banana 2.1 约为 3.3 次,Wan2.7 Image 约为 1.7 次。
再看一个具体场景。假设试点结果显示:
- 模型 A:Nano Banana 2.1,1K,每张被接受的产品图需要 1.3 次尝试。
- 模型 B:Seedream 5.0 Pro,1K,需要 1.0 次尝试。
获得 1,000 张被接受图片:
- 模型 A:1,000 × 1.3 × 2.281 = 2,965 Credits($14.83)
- 模型 B:1,000 × 1.0 × 7.5 = 7,500 Credits($37.50)
即使多了 30% 的尝试,模型 A 的成本仍远低于一半。只有当便宜模型的比值升到约 3.3 以上,或者被拒的图片在 Credits 之外还带来其他成本时,排名才会反转。
第二种情况很重要。每张被拒的图片都要花时间看,在面向用户的应用里,每次重试都意味着更多等待。如果每张结果都要人工审核,审核时间可能远超那几个 Credits。审核时间因团队而异,本文不给出具体数字,但下面的代码会记录尝试次数,方便你自己加上。
重试倍数藏在三个地方
每张被接受图片的尝试次数会因为与模型质量无关的原因而上升:
- 重复提交。 如果 worker 在轮询时超时又重新提交同一任务,你可能为两次成功付费。先保存
task_id,然后恢复轮询,不要重新提交。 - 不支持的参数。 向模型请求它不提供的宽高比或分辨率,会在提交前被拒绝,不花钱但会让流程中断。把每个模型的限制写进配置(见下文),这样从 GPT Image 2.5 Sunburst 切到 flux-2-pro 时,就不会悄悄把 16:9 发给只支持 1:1 的模型。
- 提示词漂移。 把为另一个模型调好的提示词直接用在更便宜的模型上,接受率可能下降。迁移真实流量之前,请用你自己的提示词对每个模型重新试点。
模型页上的现有公开案例
下面五张图是 Orux AI 各模型页上展示的现有公开案例,并非为本文生成,也不是质量测试。它们展示的是各模型页记录的输出类型,提示词和参数以模型页为准。
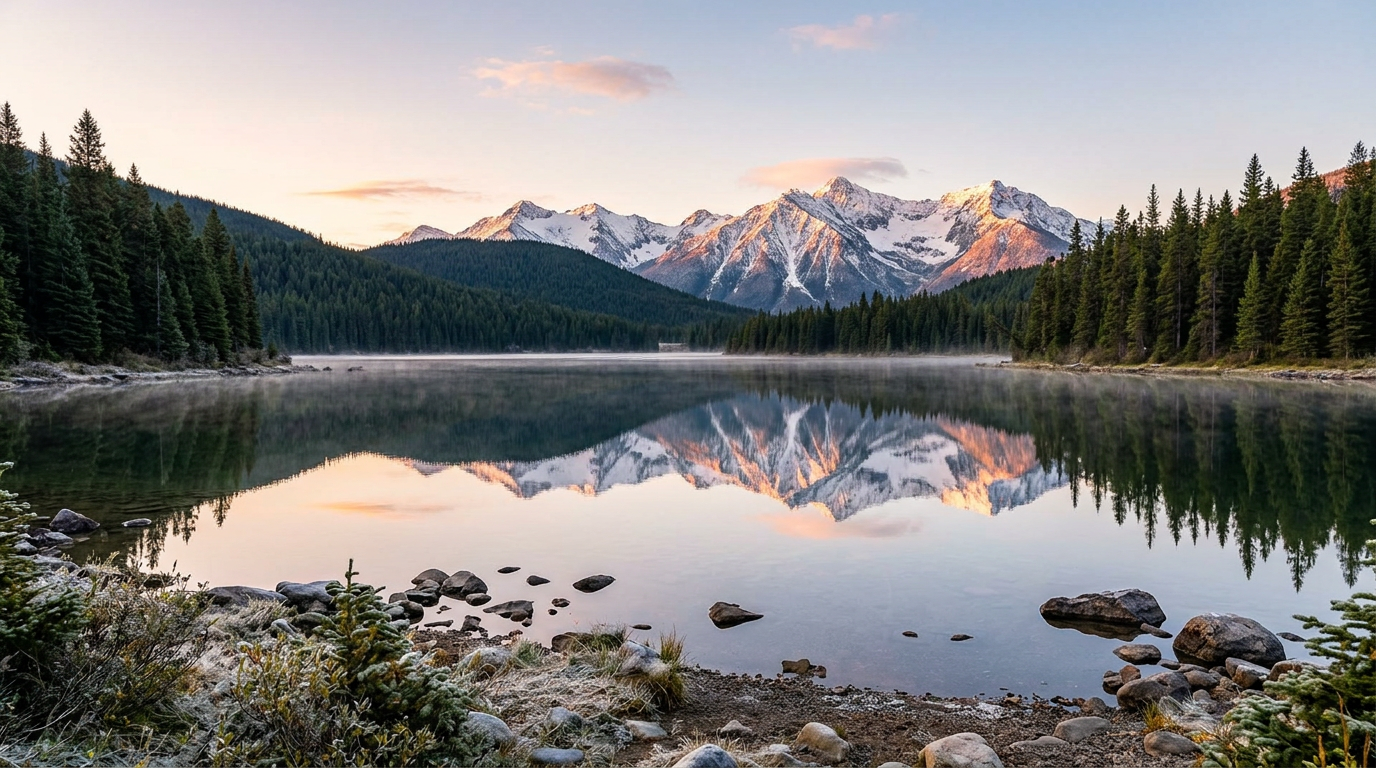
*Nano Banana 2.1 模型页的现有公开案例:"Still alpine lake perfectly reflecting snow-capped peaks and pine trees at sunrise",1K,16:9。该设置标价:2.281 Credits。*
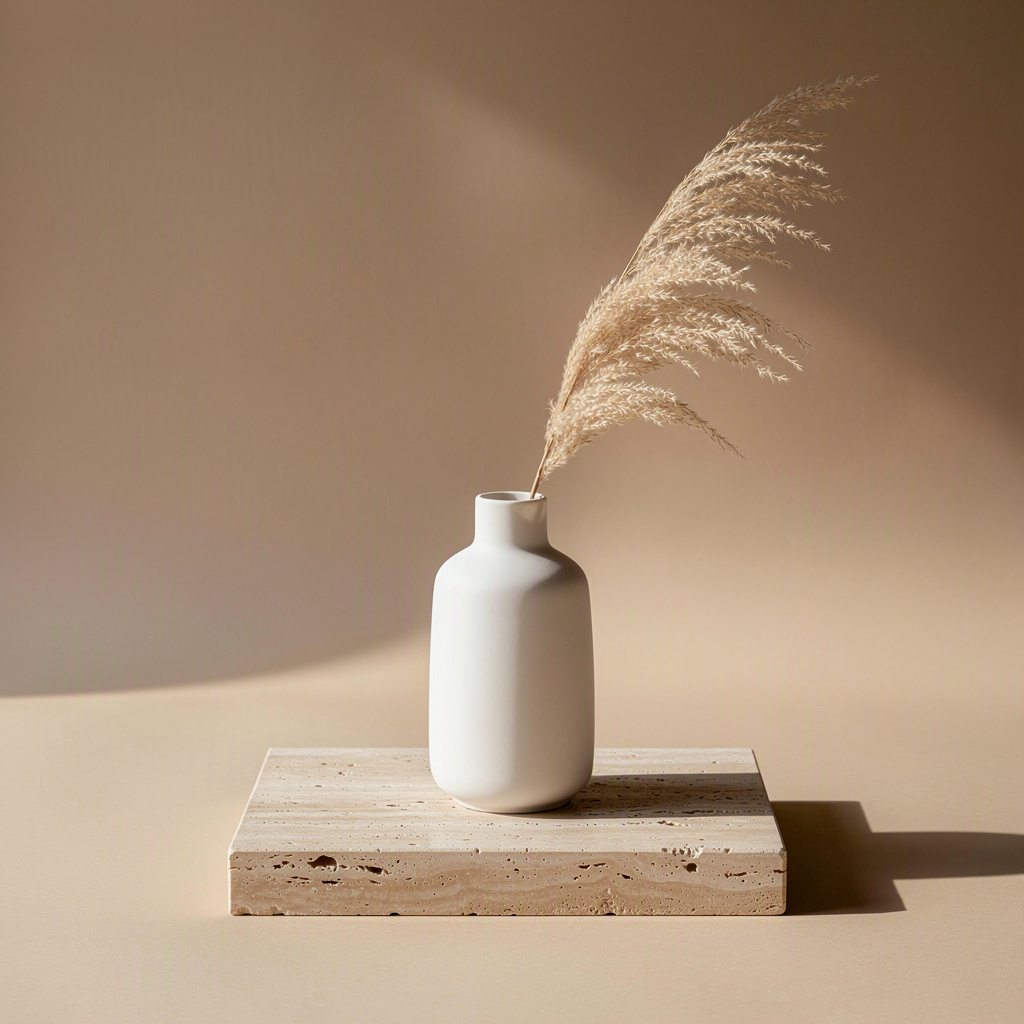
*flux-2-pro 模型页的现有公开案例:极简棚拍陶瓷花瓶产品图,1K,1:1,这是它目前唯一提供的尺寸。标价:2.67 Credits。*
*GPT Image 2.5 Sunburst 模型页的现有公开案例:黄昏中的未来海岸城市,1K,16:9。标价:任意分辨率均为 2.667 Credits。*
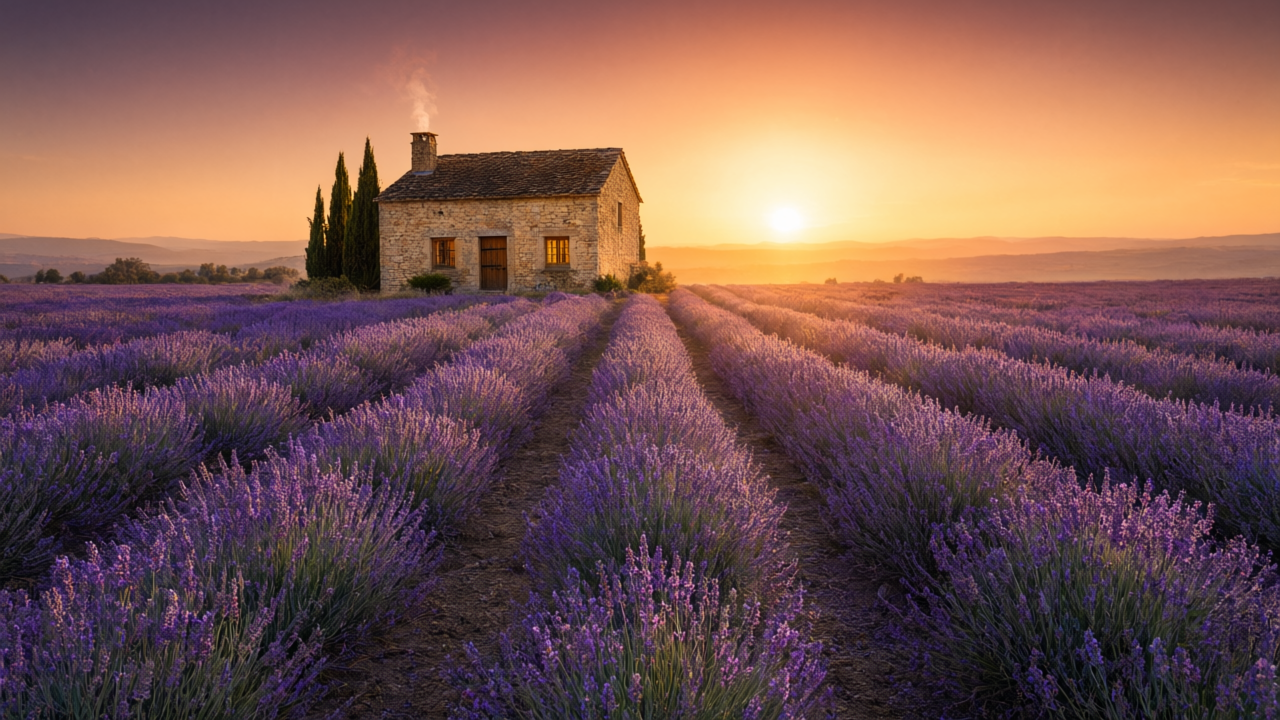
*Qwen Image 3.0 Pro 模型页的现有公开案例:日落时的薰衣草田,1K,16:9。标价:无参考图 6.667 Credits。*
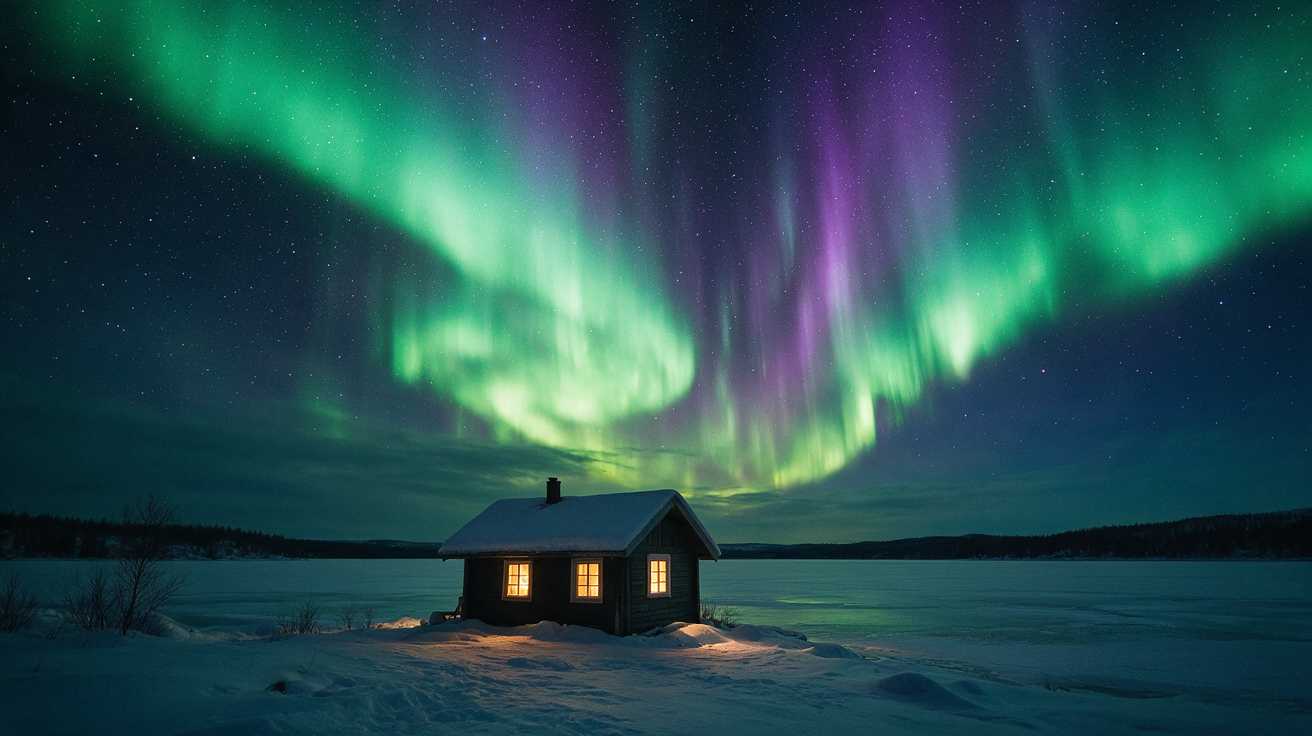
*Seedream 5.0 Pro 模型页的现有公开案例:雪地小屋上空的极光,1K,16:9。标价:无参考图 7.5 Credits。*
可以看到,其中四张都是 1K、16:9,正是可以用同一个客户端在不同模型间做 A/B 测试的设置。flux-2-pro 无法参与这种对比,因为它只能输出 1:1。
一个异步客户端,模型写在配置里
六个模型都使用同一个异步接口:POST https://orux.top/api/v1/tasks,请求体包含 model 和 input 对象,返回 HTTP 202 和 task_id。然后轮询 GET https://orux.top/api/v1/tasks/{id},直到状态变为 SUCCESS、FAILED 或 EXPIRED。模型之间只有 model 字符串和允许的 input 取值不同,所以选哪个模型应该写在配置里,而不是代码里。
下面的脚本做四件事:按各模型限制校验请求,提交并轮询,立即保存结果(结果链接是临时的),并写入一份尝试记录,便于按模型计算每张被接受图片的成本。创建 API key,导出为 ORUX_API_KEY,并安装 requests。
import json
import os
import sys
import time

import requests

BASE = "https://orux.top/api/v1"
HEADERS = {"Authorization": f"Bearer {os.environ['ORUX_API_KEY']}"}

# List prices in Credits per successful image, read from model pages on 2026-11-04.
# Keys are (resolution, reference_count) where it matters; refs surcharges omitted
# for Qwen/Seedream except the no-reference rows, so keep image_urls empty for them here.
MODELS = {
    "nano-banana-2.1": {"res": {"1K": 2.281, "2K": 2.667, "4K": 2.667},
                        "ratios": {"1:1", "16:9", "9:16", "4:3", "3:4", "3:2", "2:3", "21:9"},
                        "max_refs": 10},
    "flux-2-pro": {"res": {"1K": 2.67}, "ratios": {"1:1"}, "max_refs": 0},
    "gpt-image-2.5-sunburst": {"res": {"1K": 2.667, "2K": 2.667, "4K": 2.667},
                               "ratios": {"1:1", "16:9", "9:16", "4:3", "3:4", "3:2", "2:3", "21:9"},
                               "max_refs": 16},
    "wan2.7-image": {"res": {"1K": 4.333, "2K": 4.333},
                     "ratios": {"1:1", "16:9", "9:16", "4:3", "3:4"}, "max_refs": 9},
    "qwen-image-3.0-pro": {"res": {"1K": 6.667, "2K": 13.33},
                           "ratios": {"1:1", "16:9", "9:16", "4:3", "3:4", "3:2", "2:3"},
                           "max_refs": 0},   # refs add a surcharge; not modelled here
    "seedream-5.0-pro": {"res": {"1K": 7.5, "2K": 15.0},
                         "ratios": {"1:1", "16:9", "9:16", "4:3", "3:4", "3:2", "2:3", "21:9"},
                         "max_refs": 0},     # refs add a surcharge; not modelled here
}

# Switch models here (or via env var) without touching the rest of the code.
ACTIVE_MODEL = os.environ.get("ORUX_IMAGE_MODEL", "nano-banana-2.1")
LEDGER = "ledger.jsonl"


def build_input(prompt: str, resolution: str, aspect_ratio: str, refs=None) -> dict:
    spec = MODELS[ACTIVE_MODEL]
    refs = refs or []
    if resolution not in spec["res"]:
        raise ValueError(f"{ACTIVE_MODEL} has no {resolution}; options: {list(spec['res'])}")
    if aspect_ratio not in spec["ratios"]:
        raise ValueError(f"{ACTIVE_MODEL} does not accept {aspect_ratio}")
    if len(refs) > spec["max_refs"]:
        raise ValueError(f"{ACTIVE_MODEL}: too many reference images for this script")
    payload = {"prompt": prompt, "resolution": resolution, "aspect_ratio": aspect_ratio}
    if refs:
        payload["image_urls"] = refs
    return payload


def submit(payload: dict) -> str:
    r = requests.post(f"{BASE}/tasks", headers=HEADERS,
                      json={"model": ACTIVE_MODEL, "input": payload}, timeout=60)
    if r.status_code == 402:
        sys.exit("Insufficient balance: top up your Credits.")
    r.raise_for_status()
    return r.json()["task_id"]


def wait(task_id: str, max_wait: int = 900) -> dict:
    deadline = time.time() + max_wait
    while time.time() < deadline:
        time.sleep(5)
        r = requests.get(f"{BASE}/tasks/{task_id}", headers=HEADERS, timeout=30)
        r.raise_for_status()
        task = r.json()
        if task["status"] in ("SUCCESS", "FAILED", "EXPIRED"):
            return task
    raise TimeoutError(f"{task_id} still running: poll again later, do not resubmit")


def log(row: dict) -> None:
    with open(LEDGER, "a") as f:
        f.write(json.dumps(row) + "\n")


def generate_until_accepted(prompt, resolution="1K", aspect_ratio="1:1", max_attempts=3):
    payload = build_input(prompt, resolution, aspect_ratio)
    price = MODELS[ACTIVE_MODEL]["res"][resolution]
    for attempt in range(1, max_attempts + 1):
        task_id = submit(payload)
        log({"model": ACTIVE_MODEL, "task_id": task_id, "event": "submitted"})
        task = wait(task_id)
        if task["status"] != "SUCCESS":
            log({"model": ACTIVE_MODEL, "task_id": task_id, "event": task["status"], "credits": 0})
            continue
        urls = task.get("result") or []
        path = f"{task_id}.png"
        with open(path, "wb") as f:
            f.write(requests.get(urls[0], timeout=120).content)  # links expire: save now
        ok = input(f"Attempt {attempt}: review {path}. Accept? [y/N] ").strip().lower() == "y"
        log({"model": ACTIVE_MODEL, "task_id": task_id, "event": "accepted" if ok else "rejected",
             "credits": price})
        if ok:
            return path
    return None


def report() -> None:
    stats = {}
    with open(LEDGER) as f:
        for line in f:
            row = json.loads(line)
            s = stats.setdefault(row["model"], {"credits": 0.0, "accepted": 0, "attempts": 0})
            if row["event"] in ("accepted", "rejected"):
                s["attempts"] += 1
                s["credits"] += row["credits"]
                s["accepted"] += row["event"] == "accepted"
    for model, s in stats.items():
        if s["accepted"]:
            per = s["credits"] / s["accepted"]
            print(f"{model}: {s['attempts'] / s['accepted']:.2f} attempts/accepted, "
                  f"{per:.3f} Cr (${per * 0.005:.4f}) per accepted image")


if __name__ == "__main__":
    generate_until_accepted(
        "Minimalist studio product photograph of a matte white ceramic vase on a "
        "travertine plinth, soft window light, warm beige backdrop, no text.",
        resolution="1K", aspect_ratio="1:1")
    report()
要在同一需求上对比两个模型,分别用 ORUX_IMAGE_MODEL=nano-banana-2.1 和 ORUX_IMAGE_MODEL=gpt-image-2.5-sunburst 各运行一次,然后查看报告。记录中只把成功的图片计为已计费,与 Orux AI 的计费方式一致:FAILED 和 EXPIRED 任务按 0 Credits 记录。
关于设计的几点说明:
- 价格表是本地估算。 它用于做预算,不用于计费。价格可能变化,大批量运行前请重新查看模型页并更新数字。
- 有意没有计入 Qwen Image 3.0 Pro 和 Seedream 5.0 Pro 的参考图加价。 如果你为这两个模型加上
image_urls,请在模型页查看对应参考图数量的价格档位。 - 每 5 秒轮询一次就够了。 图像任务可能需要几分钟,请在后台 worker 中运行,不要放在 Web 请求里。
- 手动确认只是占位。 在生产环境中,你可以换成自动检查、审核队列或用户点赞。关键是每一次接受或拒绝都被记录下来。
选择默认模型和后备模型
有了真实的尝试比值,选择基本就是算术题。以下是基于模型页的如实权衡:
- Nano Banana 2.1 在本组中 1K 标价最低,参考图免费,宽高比选项也最多,适合作为高量草图的默认模型。
- GPT Image 2.5 Sunburst 在 1K、2K 和 4K 都是 2.667 Credits,因此是本组中获得 4K 输出最便宜的途径,最多支持 16 张参考图。
- flux-2-pro 价格同档,但仅支持文本输入、1K 和 1:1,只适合方形素材。
- Wan2.7 Image 每次尝试比上面三个贵,但最多 9 张参考图统一价格,对编辑密集型流程有帮助。
- Qwen Image 3.0 Pro 和 Seedream 5.0 Pro 每次尝试最贵,参考图还会加价。只有当试点显示便宜模型在你的场景(例如需要精确文字的海报)中需要多得多的重试时,它们才会在每张被接受图片的成本上胜出。
一个合理的模式是:便宜的默认模型、用于默认模型屡次失败任务的高端后备模型,以及每月重新核对一次标价和实测比值。
FAQ
什么是每张被接受图片的成本?
每张被接受图片的成本,就是每次尝试的标价乘以得到一张保留图片所需的平均尝试次数。如果一个模型每张 2.281 Credits,而你每 1.3 张结果接受 1 张,那么每张被接受图片约花费 2.965 Credits($0.0148)。
在 Orux AI 上,失败的图像任务会扣 Credits 吗?
不会。图像任务只在以 SUCCESS 结束时计费;以 FAILED 或 EXPIRED 结束的任务不收费。但你拒绝的成功图片仍会计费,这正是每张被接受图片尝试次数重要的原因。
这六个模型中,目前哪个每张最便宜?
截至 2026-11-04,本组中标价最低的是 1K 的 Nano Banana 2.1,每张 2.281 Credits($0.0114)。flux-2-pro(2.67 Cr)和 GPT Image 2.5 Sunburst(2.667 Cr)紧随其后;在 4K 下,GPT Image 2.5 Sunburst 和 Nano Banana 2.1 都是 2.667 Credits。
能不能不改代码就切换图像模型?
能,前提是模型名称和参数限制写在配置里。这里每个模型都使用相同的 POST /api/v1/tasks 和 GET /api/v1/tasks/{id} 流程,区别只在 model 字符串以及允许的分辨率、宽高比和参考图数量。
估算每张被接受图片的尝试次数需要多少测试图?
先用你的真实提示词为每个模型试点几十张,然后在生产中持续记录。小规模试点能给出粗略比值,上面脚本中的记录会随时间不断修正它。
什么时候值得用更贵的模型?
当你在便宜模型上实测的重试次数超过盈亏平衡点时,更贵的模型才值得。以一次通过的 Seedream 5.0 Pro 为基准,Nano Banana 2.1 的盈亏平衡点约为 3.3 次,Wan2.7 Image 约为 1.7 次。
用一个 API 调用这些模型
一个 OpenAI 兼容 API,覆盖对话、图像、视频与音频模型,按积分计费。
相关文章
浏览全部文章 →
图像API价格比较:10款模型的1K、2K与4K费用
比较2026年10月29日所选10款Orux图像模型的每图与百图Credits费用,保留1K、2K、4K、参考图上限和历史耗时表。明确Google Standard与Batch差异、Alibaba地区价及Qwen Pro溢价,附统一Python示例,帮助按目标分辨率和可用成片成本选模型。

Gemini API价格:12月涨价前后的费用与预算
Gemini 4 Argon于2026年12月1日、Gemini 3.8 Flash于2027年1月1日涨价。比较Standard、Batch、Flex、Priority,列出Nano Banana 2.1每图费用、三档月预算、思考tokens与缓存条件,保留Orux AI Credits价格和Python调用示例。

低价视频 API 怎么选:Vidu、Wan、Kling 与 Seedance
按2026年10月29日候选快照比较 Vidu、Wan、Kling 和 Seedance 的每秒、整段费用及输入限制,区分图生与文生、音频和画质条件。附完整批量Python代码与真实案例,诚实列出 Orux 较贵之处,复核 fal 和官方价,并说明价格舍入、任务恢复与临时链接边界。